L'essentiel
- Chaque chiffre de ce site provient d'une source publique et citable, indiquée en bas de la page où il est utilisé.
- Les caractères, les lectures et le nombre de traits viennent de la base Unicode Unihan (Unicode 18.0) ; les lectures de dictionnaire viennent de CC-CEDICT.
- Les classements de Chine continentale suivent le classement de 2019 rapporté par Wikipédia en anglais ; les chiffres de Taiwan viennent du rapport 2023 du ministère de l'Intérieur.
- Les effectifs américains viennent du fichier des noms de famille du recensement de 2010, qui enregistre des graphies, pas des caractères.
- Les outils fonctionnent dans votre navigateur avec des bibliothèques libres ; rien de ce que vous saisissez n'est envoyé à un serveur.

qiaoyu.info est une référence sur les noms de famille chinois : leurs caractères, leurs graphies, leurs origines et leur fréquence. Cette page explique d’où viennent les données, comment elles sont combinées et ce qu’elles ne peuvent pas vous dire. L’objectif est que chaque chiffre du site puisse être relié à sa source.
Principes
- Une source par chiffre. Chaque effectif, rang ou pourcentage est tiré d’une source et d’une année nommées. Les chiffres issus d’enquêtes différentes ne sont pas mélangés dans un même tableau.
- Des sources en bas de chaque page. Chaque page liste les documents sur lesquels elle s’appuie, avec des liens. Les articles de Wikipédia sont cités comme source secondaire, et les données primaires qu’ils rapportent sont citées lorsqu’elles sont publiques.
- Les caractères avant les graphies. Un nom de famille chinois est un caractère, pas une graphie en lettres latines. Un même caractère a de nombreuses graphies, et une même graphie peut désigner plusieurs caractères : les pages partent donc du caractère.
- Pas d’histoire inventée. Les récits d’origine sont rapportés comme des traditions, avec le texte ou l’historien dont ils proviennent. Lorsque les spécialistes divergent, la page le dit.
Les jeux de données
| Jeu de données | Utilisé pour | Version | Licence |
|---|---|---|---|
| Base Unicode Unihan | points de code, lectures mandarines et cantonaises, nombre de traits, clés, définitions courtes, lectures coréennes, vietnamiennes et japonaises | Unicode 18.0.0 (juillet 2026) | Licence Unicode |
| CC-CEDICT | lectures de dictionnaire et sens des noms de famille, liste des syllabes mandarines pour le tableau Wade-Giles | version du 18 novembre 2026, 125 439 entrées | CC BY-SA 4.0 |
| Fichier des noms de famille du recensement américain de 2010 | effectifs américains, rangs et part de chaque groupe de race et d’origine hispanique | 162 253 noms de famille portés par 100 personnes ou plus | domaine public |
| Wikipédia en anglais, List of common Chinese surnames | classement continental de 2019 et romanisations dans d’autres langues | consultée en novembre 2026 | CC BY-SA 4.0 |
| Ministère de l’Intérieur de Taiwan | classement de Taiwan, effectifs et noms de famille composés | statistiques du 30 juin 2023 | publication officielle |
| Wikidata | identifiants reliant chaque nom de famille à d’autres bases de données | consulté en novembre 2026 | CC0 |
| Wikimedia Commons | images | selon le fichier | licence indiquée dans chaque légende |
Comment une page de nom de famille est construite
- Choix des noms de famille. Le site a une page pour chacun des 60 noms de famille les plus courants du classement continental de 2019 rapporté par Wikipédia en anglais, plus six noms importants à Taiwan et dans la diaspora, comme Hong et Zhuang. Des caractères différents qui partagent une graphie ont des pages distinctes, comme Xu 许 à côté de Xu 徐. L’outil de recherche de nom de famille interroge un ensemble plus large de 112 noms issus du classement étendu.
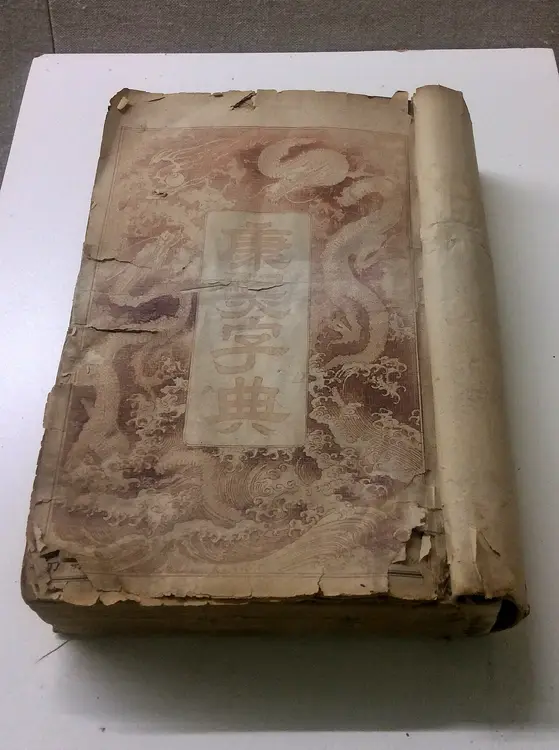
- Données de caractères. Pour chaque caractère, le script de génération lit les fichiers Unihan : lectures, nombre total de traits en forme simplifiée et traditionnelle, clé, et lectures coréennes, vietnamiennes et japonaises. Elles apparaissent dans le panneau de données en haut de chaque page de nom de famille. Les numéros de clés suivent les 214 clés du Dictionnaire de Kangxi de 1716, illustré ci-dessus, que Unihan utilise pour son index clé-traits.
- Graphies. Les romanisations en cantonais, en hokkien, en hakka et dans d’autres variétés viennent de la liste de Wikipédia, qui les rassemble à partir de plusieurs sources. Le guide un nom, plusieurs graphies explique comment les lire.
- Effectifs américains. Chaque graphie est recherchée dans le fichier du recensement de 2010. Comme le fichier n’enregistre que des graphies, un effectif pour « Wong » ou « Chang » inclut tous les noms de famille écrits ainsi ; le texte de la page explique quels caractères se cachent derrière.
- Vérification Wikidata. Un identifiant Wikidata n’est conservé que si l’élément est un nom de famille dont le libellé natif est le même caractère, afin d’éviter de relier un nom de famille à une personne ou à un lieu.
- Rédaction et relecture. Le texte est rédigé à partir des sources listées sur la page. Chaque récit d’origine, chaque date et chaque chiffre doit se retrouver dans une source citée.
Contrôles automatiques
Avant publication, un script vérifie chaque page : chaque lien interne doit pointer vers une page du registre du site, les titres et descriptions doivent respecter des limites de longueur, et chaque page doit avoir un résumé, une FAQ et au moins trois sources. Les métadonnées des images (auteur, licence et lien vers le fichier d’origine) sont récupérées sur Wikimedia Commons, et seules les images sous licence libre sont acceptées. Le site généré est ensuite contrôlé pour détecter les liens internes cassés, les données structurées invalides et les pages comportant plus d’un titre principal.
Les outils
Les outils fonctionnent entièrement dans votre navigateur :
- La recherche de nom de famille interroge les données de noms de famille du site par graphie, pinyin ou caractère.
- Le convertisseur nom chinois en pinyin utilise la bibliothèque libre pinyin-pro (licence MIT), qui dispose d’un dictionnaire de lectures de noms de famille, de sorte que 曾 se lit Zēng et 单 Shàn lorsqu’ils sont des noms de famille.
- Le convertisseur pinyin vers Wade-Giles utilise la bibliothèque use-wg (licence MIT) avec un tableau de toutes les syllabes mandarines de CC-CEDICT.
- L’outil d’ordre des traits utilise Hanzi Writer (licence MIT) avec les données de traits du projet Make Me a Hanzi, sous licence Arphic Public License. Les fichiers de données sont servis depuis ce site, pas depuis un serveur tiers.
- La recherche dans le recensement américain télécharge un extrait public du fichier de 2010 : les 13 309 noms de famille dont au moins 10 % des porteurs se sont déclarés Asiatiques ou insulaires du Pacifique.
Limites des données
- Les graphies ne sont pas des caractères. Le recensement américain, comme la plupart des registres occidentaux, ne conserve que les lettres latines. Une graphie peut correspondre à plusieurs noms de famille chinois, et à des noms coréens ou vietnamiens.
- Les effectifs varient selon la source. Les chiffres continentaux proviennent de données d’état civil publiées à des dates différentes ; la page combien de noms de famille chinois existent-ils explique pourquoi les totaux vont d’environ 3 100 à 4 100.
- Caractères variantes. Taiwan compte séparément les formes écrites, si bien que 黃 et 黄 figurent comme deux entrées. Les statistiques continentales utilisent les caractères simplifiés, qui fusionnent certaines formes.
- Les traditions ne sont pas des registres. La plupart des récits d’origine remontent à des textes rédigés des siècles après les événements qu’ils décrivent. Ils disent ce que les familles croient de leurs ancêtres, pas ce qui peut être prouvé.
Corrections
Si vous trouvez une erreur, écrivez à l’adresse indiquée dans les mentions légales, en précisant la page et, si possible, une source. Chaque correction est vérifiée par rapport aux données d’origine, et la date de mise à jour de la page change lors de la publication. Les données et images du site sont listées avec leurs licences dans les mentions légales ; voir aussi la politique de confidentialité.
Questions fréquentes
D'où viennent les classements de noms de famille ?
Pour la Chine continentale, du classement de 2019 fondé sur les données du ministère de la Sécurité publique, tel que rapporté dans la liste des noms de famille chinois courants de Wikipédia en anglais. Pour Taiwan, des statistiques des noms 2023 du ministère de l'Intérieur. Chaque page nomme ses sources et renvoie vers elles.
Pourquoi certains chiffres diffèrent-ils d'autres sites ?
Les effectifs de noms de famille dépendent de l'année, de la population couverte et de la façon de compter les caractères variantes. Ce site indique l'année et la source de chaque chiffre au lieu de mélanger des décomptes issus d'enquêtes différentes.
Puis-je réutiliser les données ?
Les jeux de données de départ sont ouverts : Unihan sous licence Unicode, CC-CEDICT sous CC BY-SA 4.0, le fichier du recensement américain dans le domaine public et Wikidata sous CC0. Réutilisez-les selon leurs propres conditions et citez la source d'origine. Les images conservent la licence indiquée dans leur légende.
Comment signaler une erreur ?
Utilisez l'adresse de contact des mentions légales. Indiquez la page, l'affirmation concernée et, si possible, une source. Les corrections sont vérifiées par rapport aux données d'origine avant la mise à jour de la page.
Sources et données ouvertes
- Unihan database, Unicode Consortium
- CC-CEDICT, MDBG and CC-CEDICT contributors
- Frequently Occurring Surnames from the 2010 Census, US Census Bureau
- List of common Chinese surnames, English Wikipedia
- 全國姓名統計分析 (National name statistics, 2023), Department of Household Registration, Ministry of the Interior (Taiwan)
- Wikidata, Wikimedia Foundation